Hva en språkmodell er, og hva den ikke er Del 1 av 2
Hva en språkmodell er og ikke er
Prøv en ekte, ørliten språkmodell som kjører i nettleseren, og se med egne øyne hvordan den deler opp tekst, gjetter neste orddel og trekker fra sannsynligheter. Se så hva den samme mekanismen blir til i de største modellene.
- Sist oppdatert
- Bygger på
- Øvingen bygger på notatboka «En språkmodell på nært hold» av Erling Midtgard, FIKS, Universitetet i Oslo (2026), CC BY 4.0.
- Figuren over KI-feltet er fra den samme notatboka.
- Etterpå kan du
-
- forklare med egne ord hva en språkmodell gjør når den skriver, og hvorfor den kan ta feil med stor selvsikkerhet
- forklare hva tokens, sannsynligheter og temperatur er, med et eksempel fra øvingen
- plassere store språkmodeller i KI-feltet, og vite at de er én liten del av det
- forklare hvorfor skalaen gjør at en neste-orddel-gjetter i praksis kan løse de fleste oppgavene vi gir
Ramme
Hvorfor dette angår undervisningen din
Vi trenger ikke kunne matematikken bak en språkmodell, men vi trenger et bilde i hodet av hva som faktisk skjer når vi skriver noe i Sikt KI.
Uten det bildet er det vanskelig å vite når vi kan stole på et svar, og enda vanskeligere å forklare elevene hvorfor KI kan ta feil med stor selvsikkerhet. Vi har snakket om kompetanseillusjonen, at KI-svar har så god flyt at vi tror vi har forstått mer enn vi har. Den flyten er ikke tilfeldig. Den er nettopp det en språkmodell er laget for å produsere.
I denne delen skal du prøve en ekte språkmodell, bare veldig liten. Den er trent på én eneste tekst, overordnet del av læreplanverket, og den kjører i nettleseren din uten at noe sendes noe sted. Den er ørliten sammenlignet med modellene bak Sikt KI, men den fungerer etter nøyaktig de samme prinsippene. Poenget er at du skal se det med egne øyne, ikke bare høre det fra oss.
En språkmodell er en neste-orddel-gjetter. Den fortsetter tekst, den svarer ikke, og den har ikke noe begrep om sant og usant, bare om hva som er sannsynlig.
Info
Det du trenger å vite
Hvor språkmodellene hører hjemme
Store språkmodeller er bare én liten del av KI-feltet. Når vi sier «KI» på skolen, mener vi som regel språkmodellene, men stavekontrollen og spamfilteret er også KI, bare av en helt annen sort.
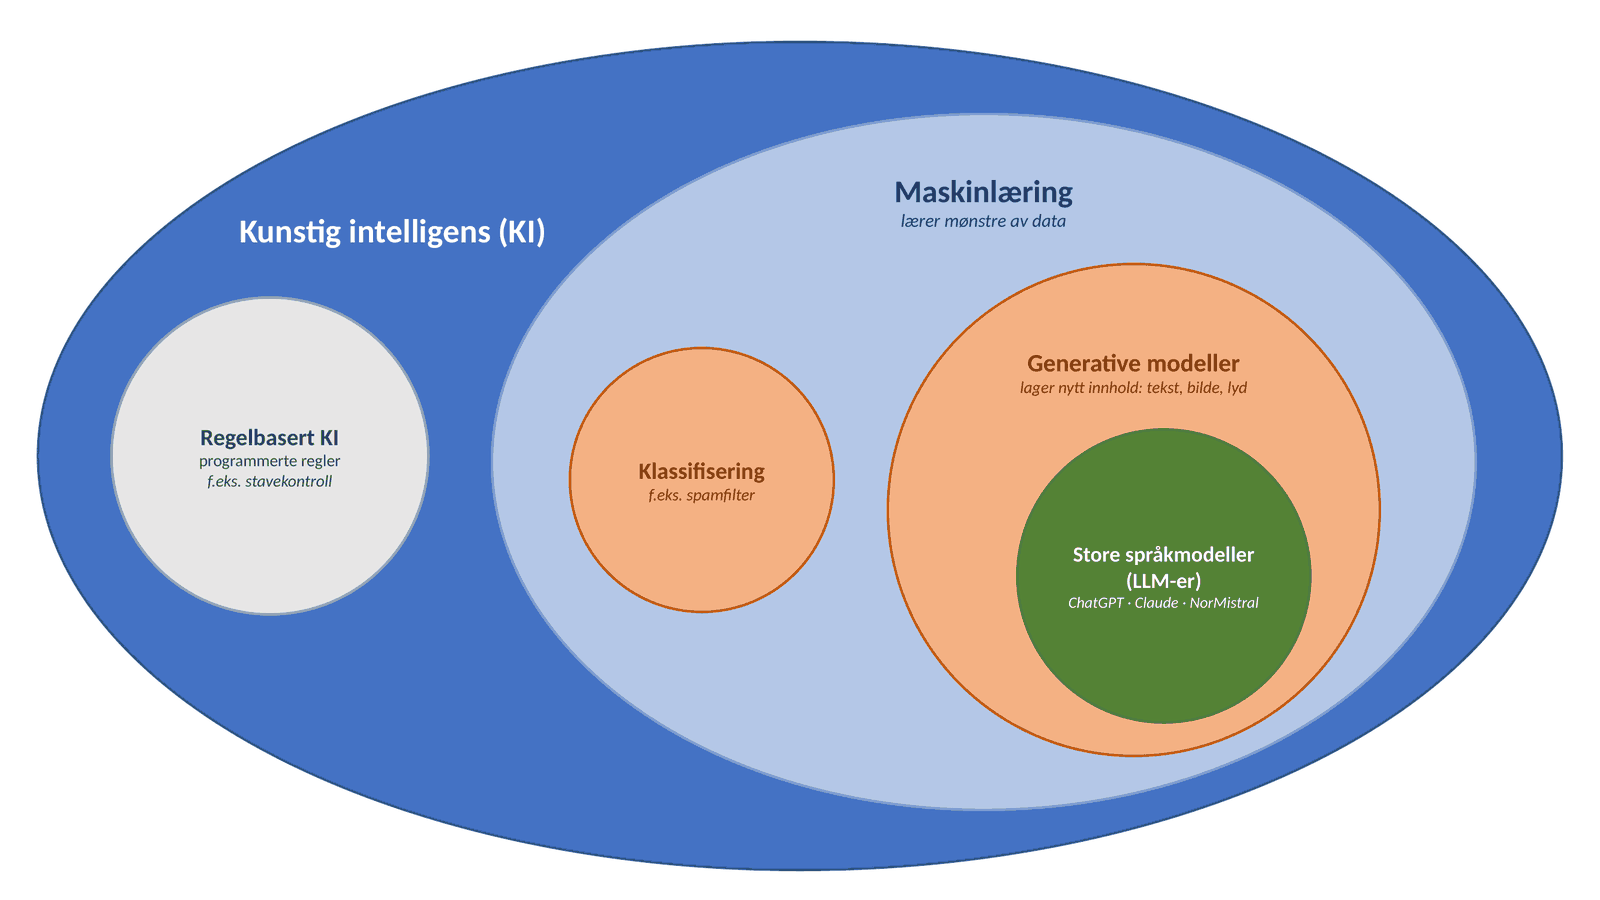
Et nivå er utelatt for enkelhets skyld: mellom maskinlæring og generative modeller ligger dyp læring, altså nevrale nettverk.
En språkmodell er to deler
- Tokenizeren deler teksten i biter, tokens, og gir hver bit et nummer. Et token er ofte et helt ord, men like ofte en orddel. Tallrekken er det eneste modellen ser.
- Selve modellen er de trente vektene, eller parameterne, som regner ut hvor sannsynlig hvert eneste token er som fortsettelse.
Å skrive tekst er bare å gjenta det samme om og om igjen: gjett neste token, heng det på slutten, gjett igjen. Modellen stopper når den trekker et eget sluttoken, <eos>, som den har lært å sette der avsnittene i treningsteksten sluttet. Ellers stopper den når den når makslengden vi har satt, gjerne midt i en setning.
Tilfeldigheten er et valg
Modellen gir aldri ett svar, men en fordeling av sannsynligheter, og neste token trekkes fra den, som i et lotteri der de beste forslagene har flest lodd. Hvor vill trekningen skal være, styres med temperaturen. Lav temperatur holder seg til favorittene, høy temperatur gir også de usannsynlige forslagene en sjanse, og da rakner språket.
At modellen trekker tilfeldig, betyr likevel ikke at den er usikker. Vi kan skru av lotteriet helt og få nøyaktig samme tekst hver gang. Tilfeldigheten er noe vi velger fordi vi vil ha variasjon i språket, ikke et tegn på at modellen tviler.
Fra minimodell til Sikt KI
Modellen i øvingen er en basemodell. Den fortsetter tekst, og det er alt. Veien derfra til modellene bak Sikt KI handler om to ting: skala, altså milliarder av parametere og enorme mengder tekst, og videre trening der modellen lærer å følge instruksjoner og svare slik mennesker foretrekker. Det er den siste delen som gjør at den svarer når du spør. Men under svaret er det fortsatt en neste-orddel-gjetter.
Tre ting å ta med seg
- En språkmodell lærer mønstre fra treningsgrunnlaget sitt. Minimodellen kan bare læreplansk. De store har sett så mye at mønstrene blir svært generelle.
- En språkmodell trenger en tokenizer som gjør språk om til tall. Det modellen aldri har sett, blir ukjent.
- En språkmodell regner ut sannsynligheter for alle tokens, og vi bestemmer hvordan neste token skal velges.
Vil du se mer?
- Store språkmodeller forklart kort er en kort video fra 3Blue1Brown, som er kjent for å forklare matematikk visuelt og presist. Den er på engelsk og viser det samme som øvingen, med flotte animasjoner. Den åpnes på YouTube.
- Fordeler og risikoer ved KI er en oversikt fra Rådet i EU, på engelsk. Den forklarer hvorfor EU har laget egne regler for KI, og er et godt utgangspunkt hvis du vil se den store sammenhengen.
Utføring
Gjør det, helst med ditt eget materiale
Øvingen under er en ekte språkmodell med 912 128 parametere, trent på overordnet del av LK20. Den kan bare «læreplansk». Gå gjennom de tre delene i rekkefølge.
Denne øvingen trenger JavaScript for å virke.
Tenk over
Prøv deg fram, og ta stilling til disse underveis. Det er ingen fasit her, men det er verdt å kunne svare.
- Hvordan endrer teksten seg når du skrur temperaturen fra 0,2 til 2,2? Når begynner den å lage ord som ikke finnes, og hvorfor skjer det?
- Skriv et spørsmål, for eksempel «Hva er tilpasset opplæring?». Svarer modellen? Hva skjer med spørsmålstegnet?
- Skriv noe modellen aldri har sett, for eksempel et ord med c, w eller z. Hva skjer i del 1, og hva gjør det med teksten?
- Lås trekningen og generer to ganger. Hva sier det om påstanden at KI er «usikker»?
Med lav temperatur skriver minimodellen ofte setninger som står ordrett i læreplanen. Med høy temperatur blir det nonsens.
Og så: skalaen
Det er lett å gå fra øvingen med feil konklusjon. «Den gjetter jo bare neste orddel» er riktig, men det betyr ikke at den ikke kan noe. Minimodellen har under en million parametere og har lest om lag 12 000 tokens. Da OpenAI trente GPT-6, var det første gang de brukte mer enn 100 000 grafikkprosessorer samtidig til én treningsrunde. Forskjellen er ikke en forbedring, men et helt annet størrelsesnivå.
Og skalaen gjør noe med hva neste-orddel-gjettingen blir til. Skal en modell gjette neste ord i en matematisk utledning, et juridisk resonnement eller en kodelinje, lønner det seg for den å ha lært noe som fungerer som resonnering. Om det «egentlig» er tenking, er noe forskere og filosofer fortsatt er uenige om. For oss i klasserommet er spørsmålet et annet, og det er langt enklere: de nyeste modellene kan løse de aller fleste oppgavene vi gir elevene, og mange av oppgavene vi selv ville slitt med.
| Modell | Kom | Det selskapet sier den kan |
|---|---|---|
| GPT-6 Astra (OpenAI) | 3. september 2026 | Det beste innen koding, bruk av datamaskin og nettleser, vitenskap og profesjonelt arbeid. Kan gjennomføre lange oppgaver i flere steg, som å fylle ut en selvangivelse eller lage en scene i et dataspill. Den første modellen OpenAI selv har vurdert som kritisk innen cybersikkerhet |
| Claude Fable 5.2 (Anthropic) | 9. november 2026 | Jobber med store, løst formulerte problemer i flere dager, og styrer hundrevis av andre KI-agenter. Ifølge Anthropic formaliserte 1 000 agenter et av de mest kjente bevisene i matematikken, Fermats siste teorem, på 30 timer |
Tallene og påstandene kommer fra selskapene selv, og de har all grunn til å vise seg fram. Likevel er retningen tydelig, og den går fort: modellene i tabellen kom med to måneders mellomrom.
Se hva de kan
Les mer hos selskapene: GPT-6 Astra og Claude Fable 5.2.
En kollega sier: «En språkmodell gjetter bare neste ord, så den kan ikke løse en ordentlig drøftingsoppgave.»
En elevtekst skrevet av KI
[INNHOLD KOMMER: elevtekst skrevet med KI, som vedlegg til denne delen]
Les teksten som om en elev hadde levert den. Ville du sett at den var skrevet av KI? Hva i oppgaven gjorde det mulig å la KI skrive den? Det er de spørsmålene vi tar videre i modulen om VUKI-kompasset og oppgavedesign.
Bruk og refleksjon
Prøv det i undervisningen og skriv ned hva som skjedde
Øvingen egner seg også for elever, kanskje særlig når vi snakker om kildekritikk og kompetanseillusjonen. Vis den på storskjermen, og la elevene foreslå starter og temperaturer. Spør dem etterpå hvorfor en modell som bare gjetter neste orddel, likevel kan skrive noe som høres helt riktig ut, og hva det betyr for hvordan de bør lese et KI-svar.
Skriv ned etterpå, i dine egne notater og uten elevnavn:
- Hvilken del av øvingen gjorde mest inntrykk, på deg eller på elevene?
- Ble det lettere å forklare hvorfor KI kan ta feil med stor selvsikkerhet?
- Er det noe ved hvordan du selv leser KI-svar, som du vil endre?